模倣学習(カメラ E2E)
要点
- 前方カメラの画像から、舵角を直接出すニューラルネットワークで走るモードです。2026-11-13 からは、前方のステレオの左右 2 枚の画像を入れます。地面への投影(IPM)も LiDAR も使いません。
- 手本は、人の手動運転か、うまく走れている LiDAR の自動運転(地図走行)です。走行の記録から「画像と、その瞬間の操作」の組を取り出すだけで教師データになります。
- 手本は同じ線しか走らないので、そのままでは「線から外れたときに戻す舵」を覚えません。そこで画像を左右にずらし、戻す向きに補正した舵を一緒に教えます。
【実機確認】(周回)+【シム/ホスト検証】(オフライン評価)
対象: 実車側 cam_e2e.py・cam_e2e_node.py、学習側 ml_cam_e2e/。確認した版: 上位 7c7054e。
実車での結果は開発者の記録(2026-10-29〜30)からの引用で、カメラ 1 台の頃のモデル(v9)のものです。左右 2 台の入力に変えた後のモデルは、まだ学習していません(左右 2 台にした)。このモードは障害物では止まりません(後述)。
しくみ
全体の流れ
flowchart LR
  R["走行を記録<br/>画像+操作(mcap)"] --> E["① 組を取り出す"]
  E --> V["② 悪い手本を外す"]
  V --> B["③ 偏りを見る"]
  B --> T["④ 学習<br/>拡張つき"]
  T --> X["⑤ ONNX に書き出す"]
  X --> P["実車で推論<br/>Raspberry Pi 5"]
  T --> EV["⑥ 評価"]
  EV -.->|誤差の大きい場面| V
学習は Mac 上で行い、書き出したモデル(ONNX)を実車に配ります。実車では cam_e2e_node が前方カメラの画像からモデルで舵角を推論し、走行モードがそれを指令にします。
なぜ画像から直接舵を出すのか
カメラは車体の低い位置にあり、画像を床の座標に直す IPM では、遠くほど奥行きの誤差が大きくなります。 実車で「奥行きを掴むのが難しい」と分かったので、幾何の変換を一切通さず、画像と操作の関係を直接学ばせることで、その問題を迂回しました(カメラで道を見る)。
| 中身 | |
|---|---|
| モデル | MobileNetV3-Small を土台に、全体を平均してから全結合で回帰する軽量なモデル |
| 入力 | 前方のステレオの左右 2 枚の画像(右・左の順。学習の既定は各 224 × 128) |
| 出力 | 舵角(−1〜1 に正規化。1 が左いっぱい)と速度(学習の既定では使わない) |
| 教師データ | 走行記録の画像と、その少し後の操作の組 |
左右 2 台にした
2026-11-13 に前方のカメラを左右 2 台のステレオにしたのに合わせて(センサ)、入力も右 1 枚から左右の同期した 2 枚に変えました。
- 左右で別の情報になる。 右カメラの右下には右前輪の横の床、左カメラの左下には左前輪の横の床が写ります。横の位置を知る一番強い手がかりである近くの縁が、2 台で別々に見えます。
- 骨格は左右で共有する。 右と左を同じ骨格(MobileNetV3-Small)に通し、出てきた特徴を右・左の順につないでから回帰します。重みが骨格 2 本の半分で済み、少ないデータでも崩れにくいためです。6 チャネルを 1 枚の画像として入れないのは、同じ物が左右で違う画素に写る(視差がある)からです。
- 左右反転の水増しは「左右を入れ替えて、それぞれ鏡像」にする。 取付が左右対称なので、鏡像にした左の絵は「鏡の世界での右カメラの絵」になります。
- 代わりに、推論の計算はほぼ倍になります。
視点が変わったので、カメラ 1 台用の旧いモデル(v1〜v11)は Mac と Pi の両方から消しました。左右 2 台で記録を録り直して、学習し直す必要があります。 今は Mac のテストまでで、Pi への反映、推論の遅れと電流の測定、記録と学習はまだです(検証状況)。
速度は学ばせない
速度は、モデルが出した舵角から曲率 \(\kappa = \tan\delta / L\) を求め、横加速度の上限 \(v \le \sqrt{a_{\mathrm{lat,max}}/\kappa}\) で決めます。直線では最高速度、舵を切るほど遅くなります。
人の運転から速度を学ばないのは、手本は舵に集中してゆっくり走った方が質が上がり、速度のラベルは「遅い一定値」になって情報が無く、 しかも手本の遅さがそのまま実車の上限になってしまうからです。代わりに、舵が切れてから減速するので、コーナー手前の減速は遅れます。
学習の操作パネル
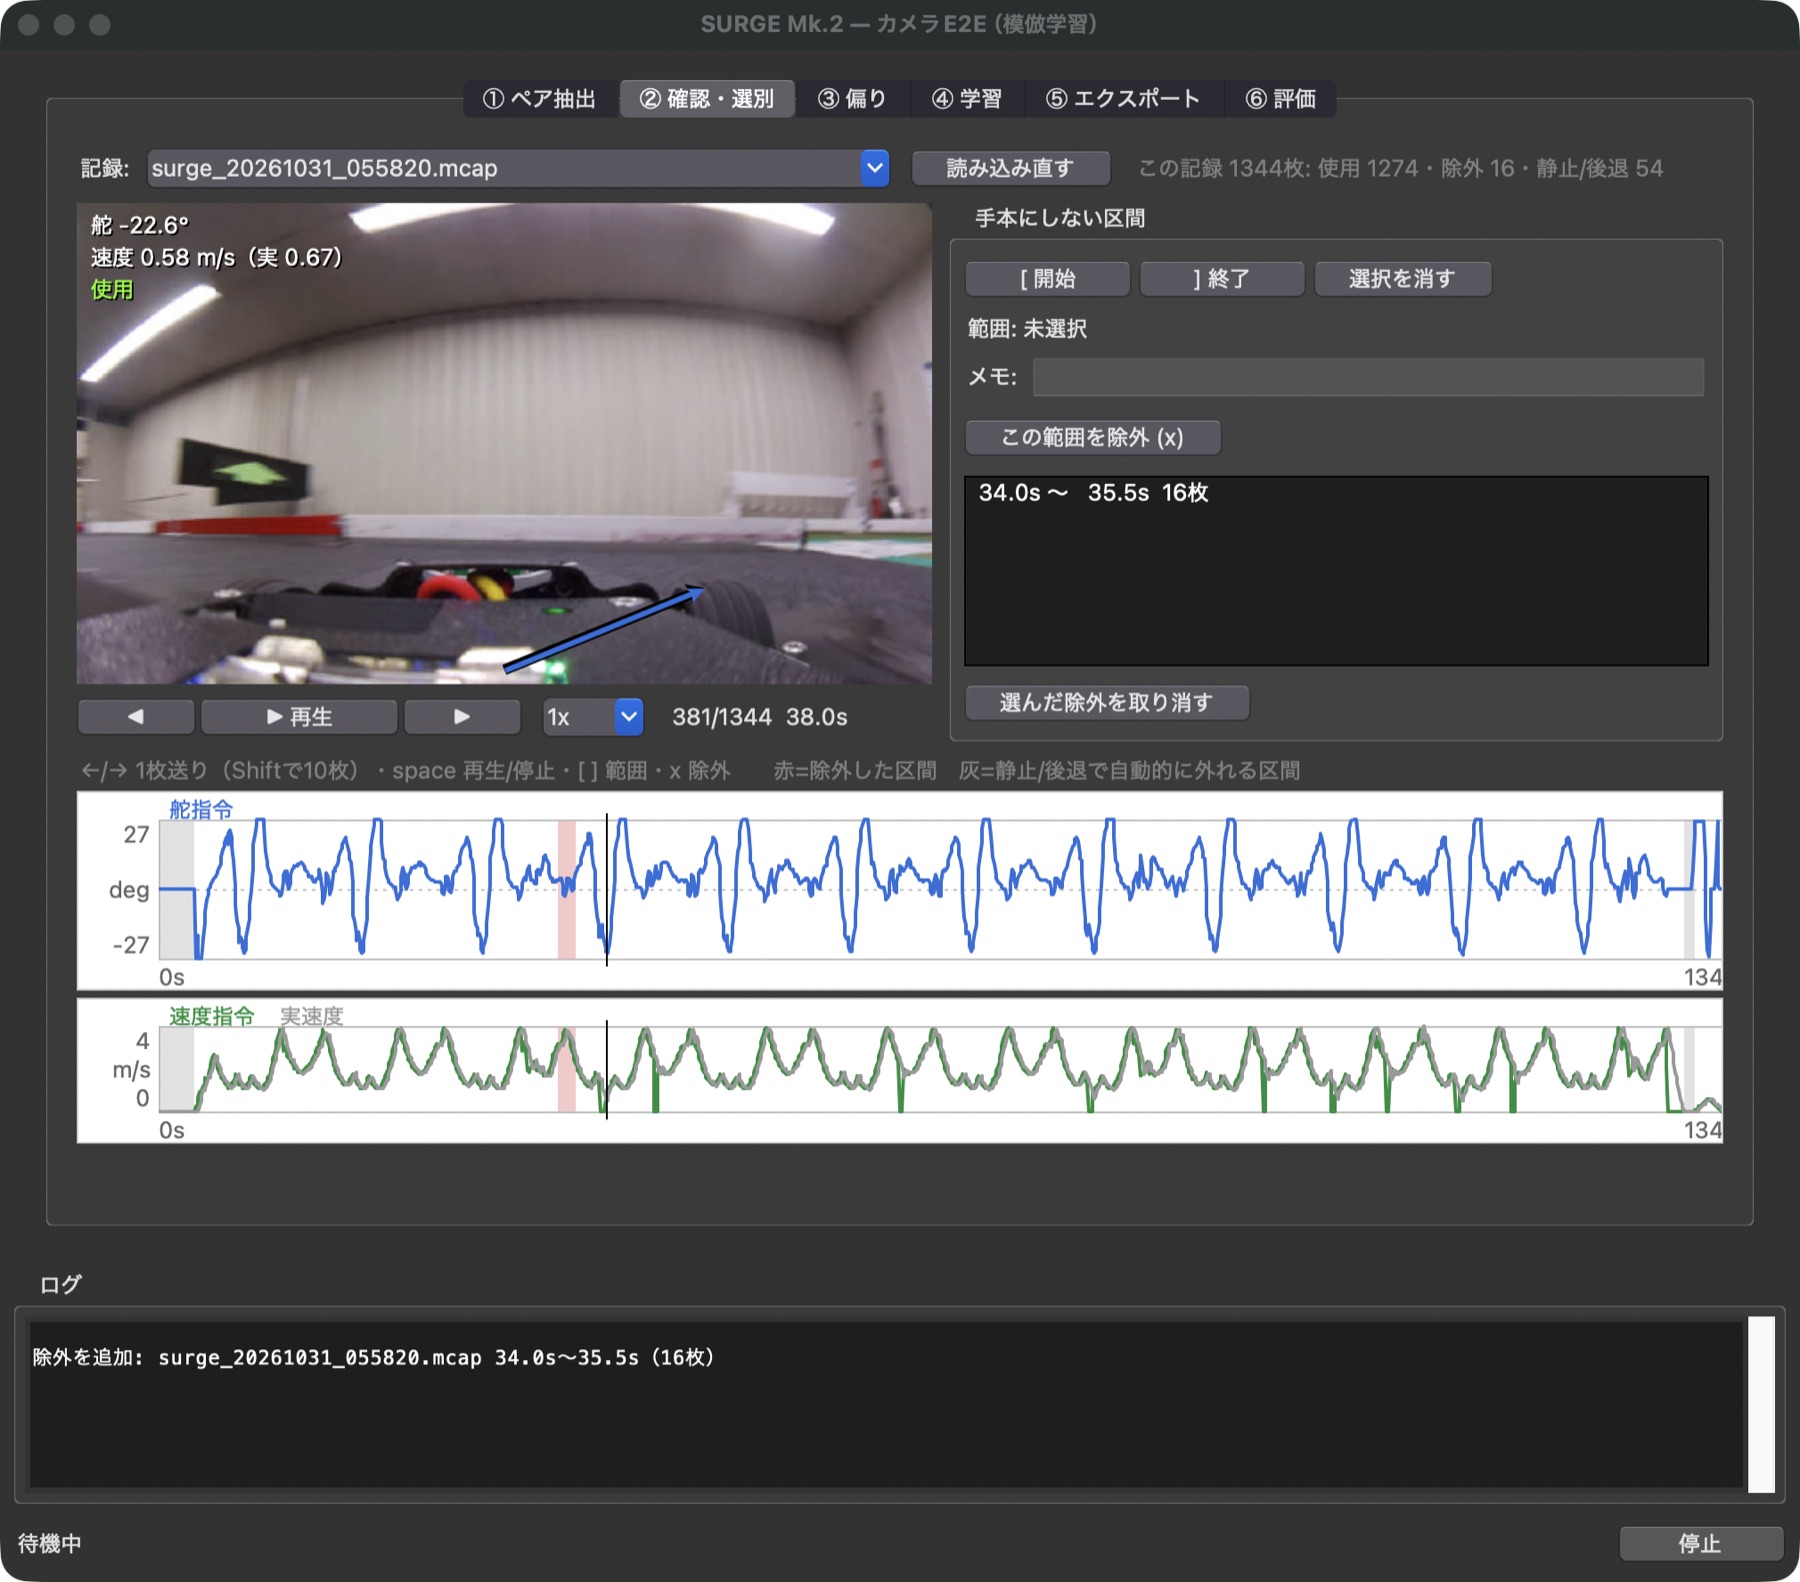
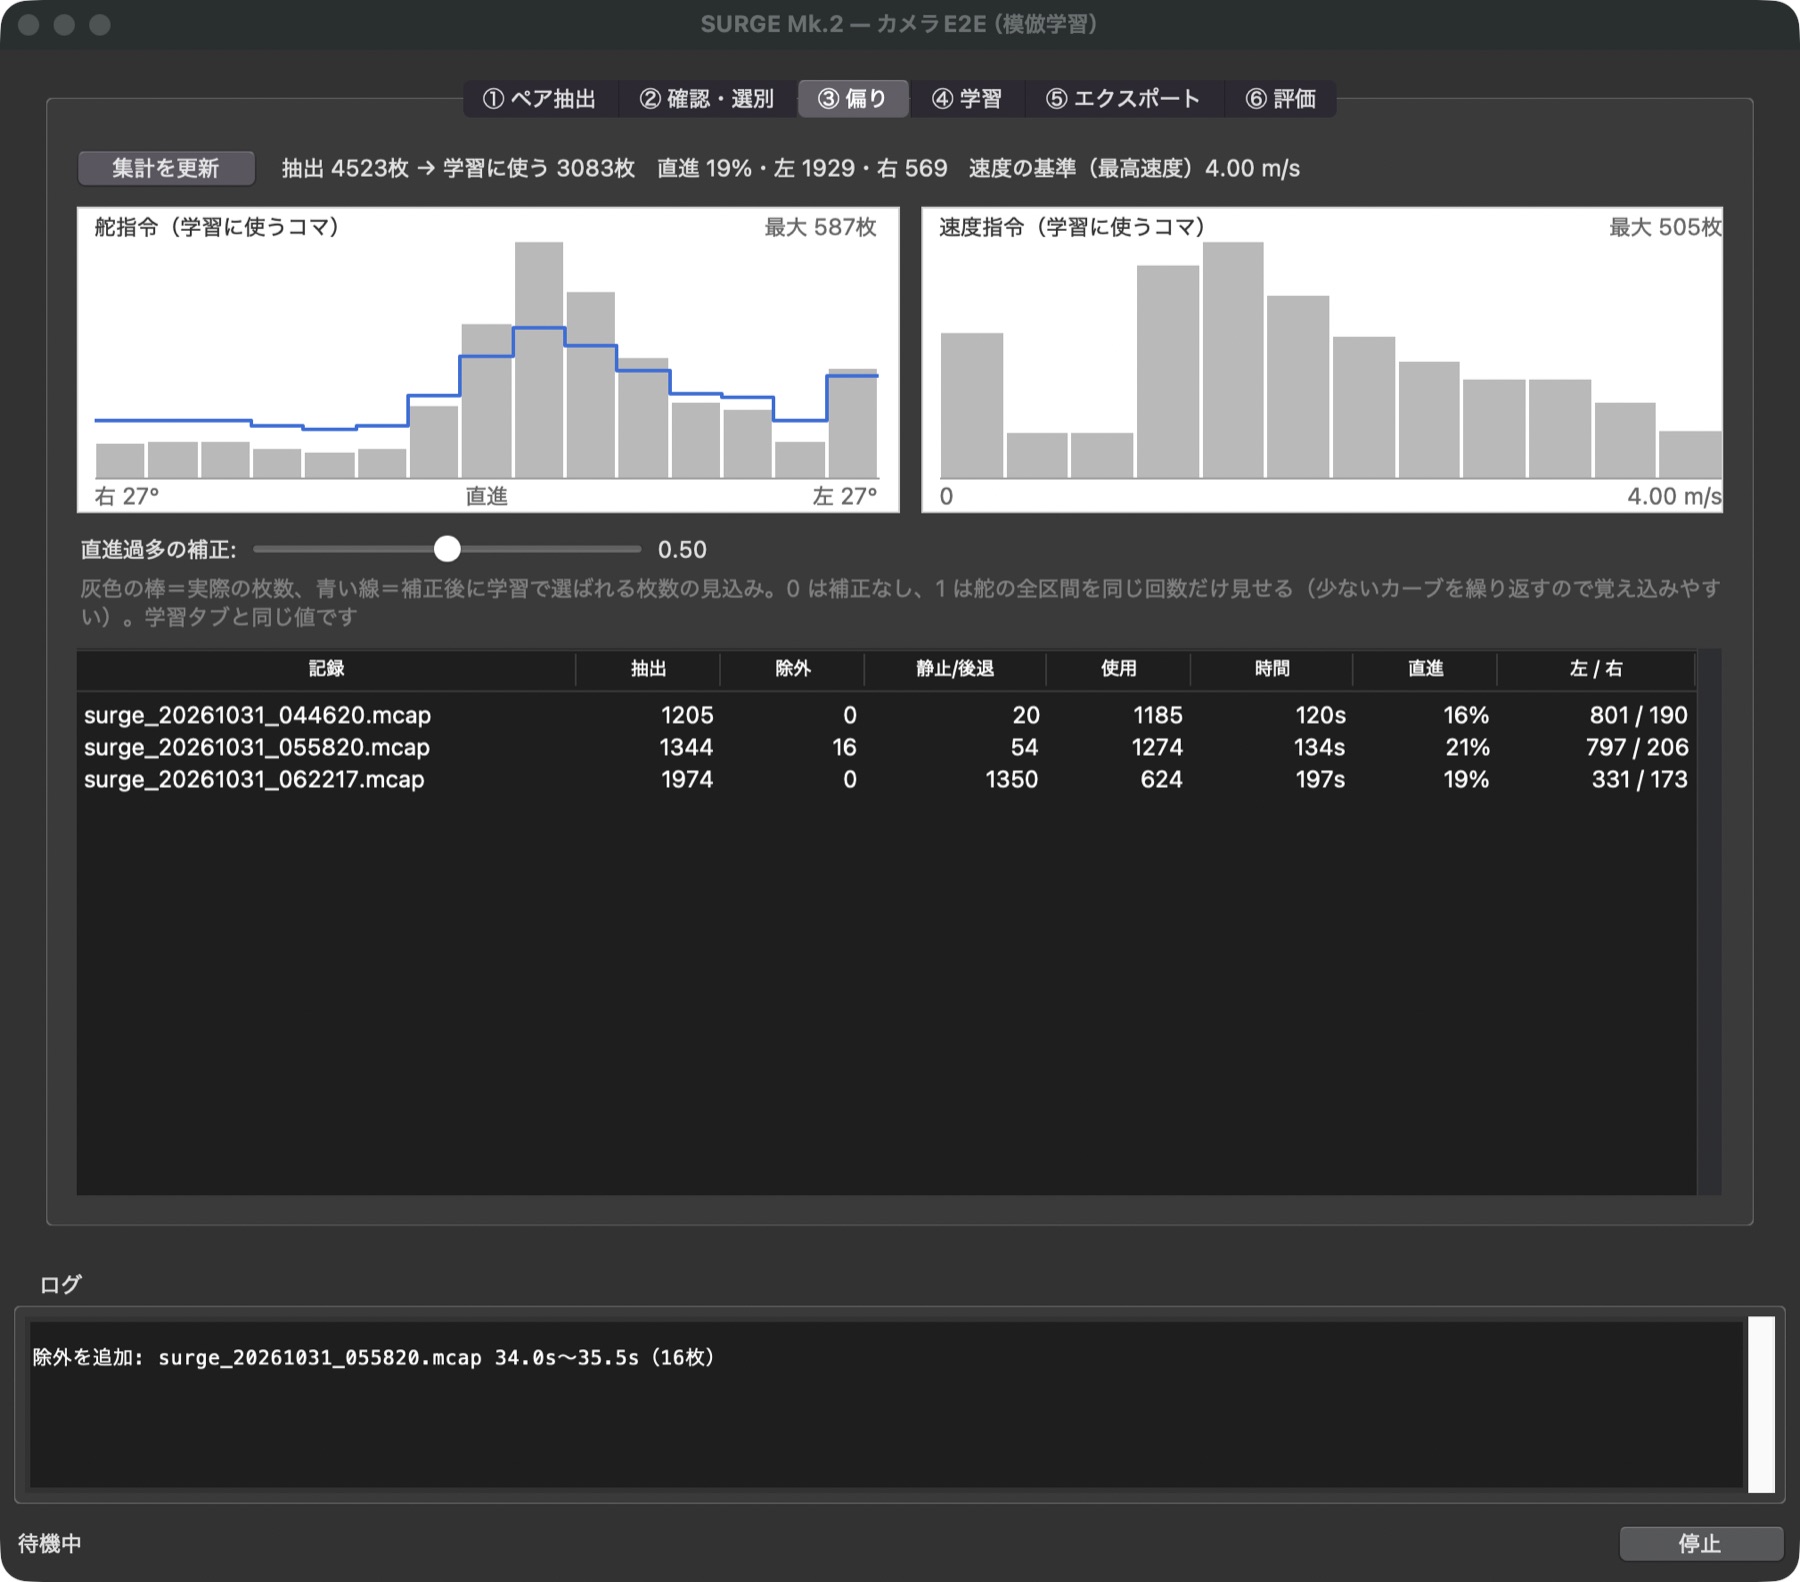
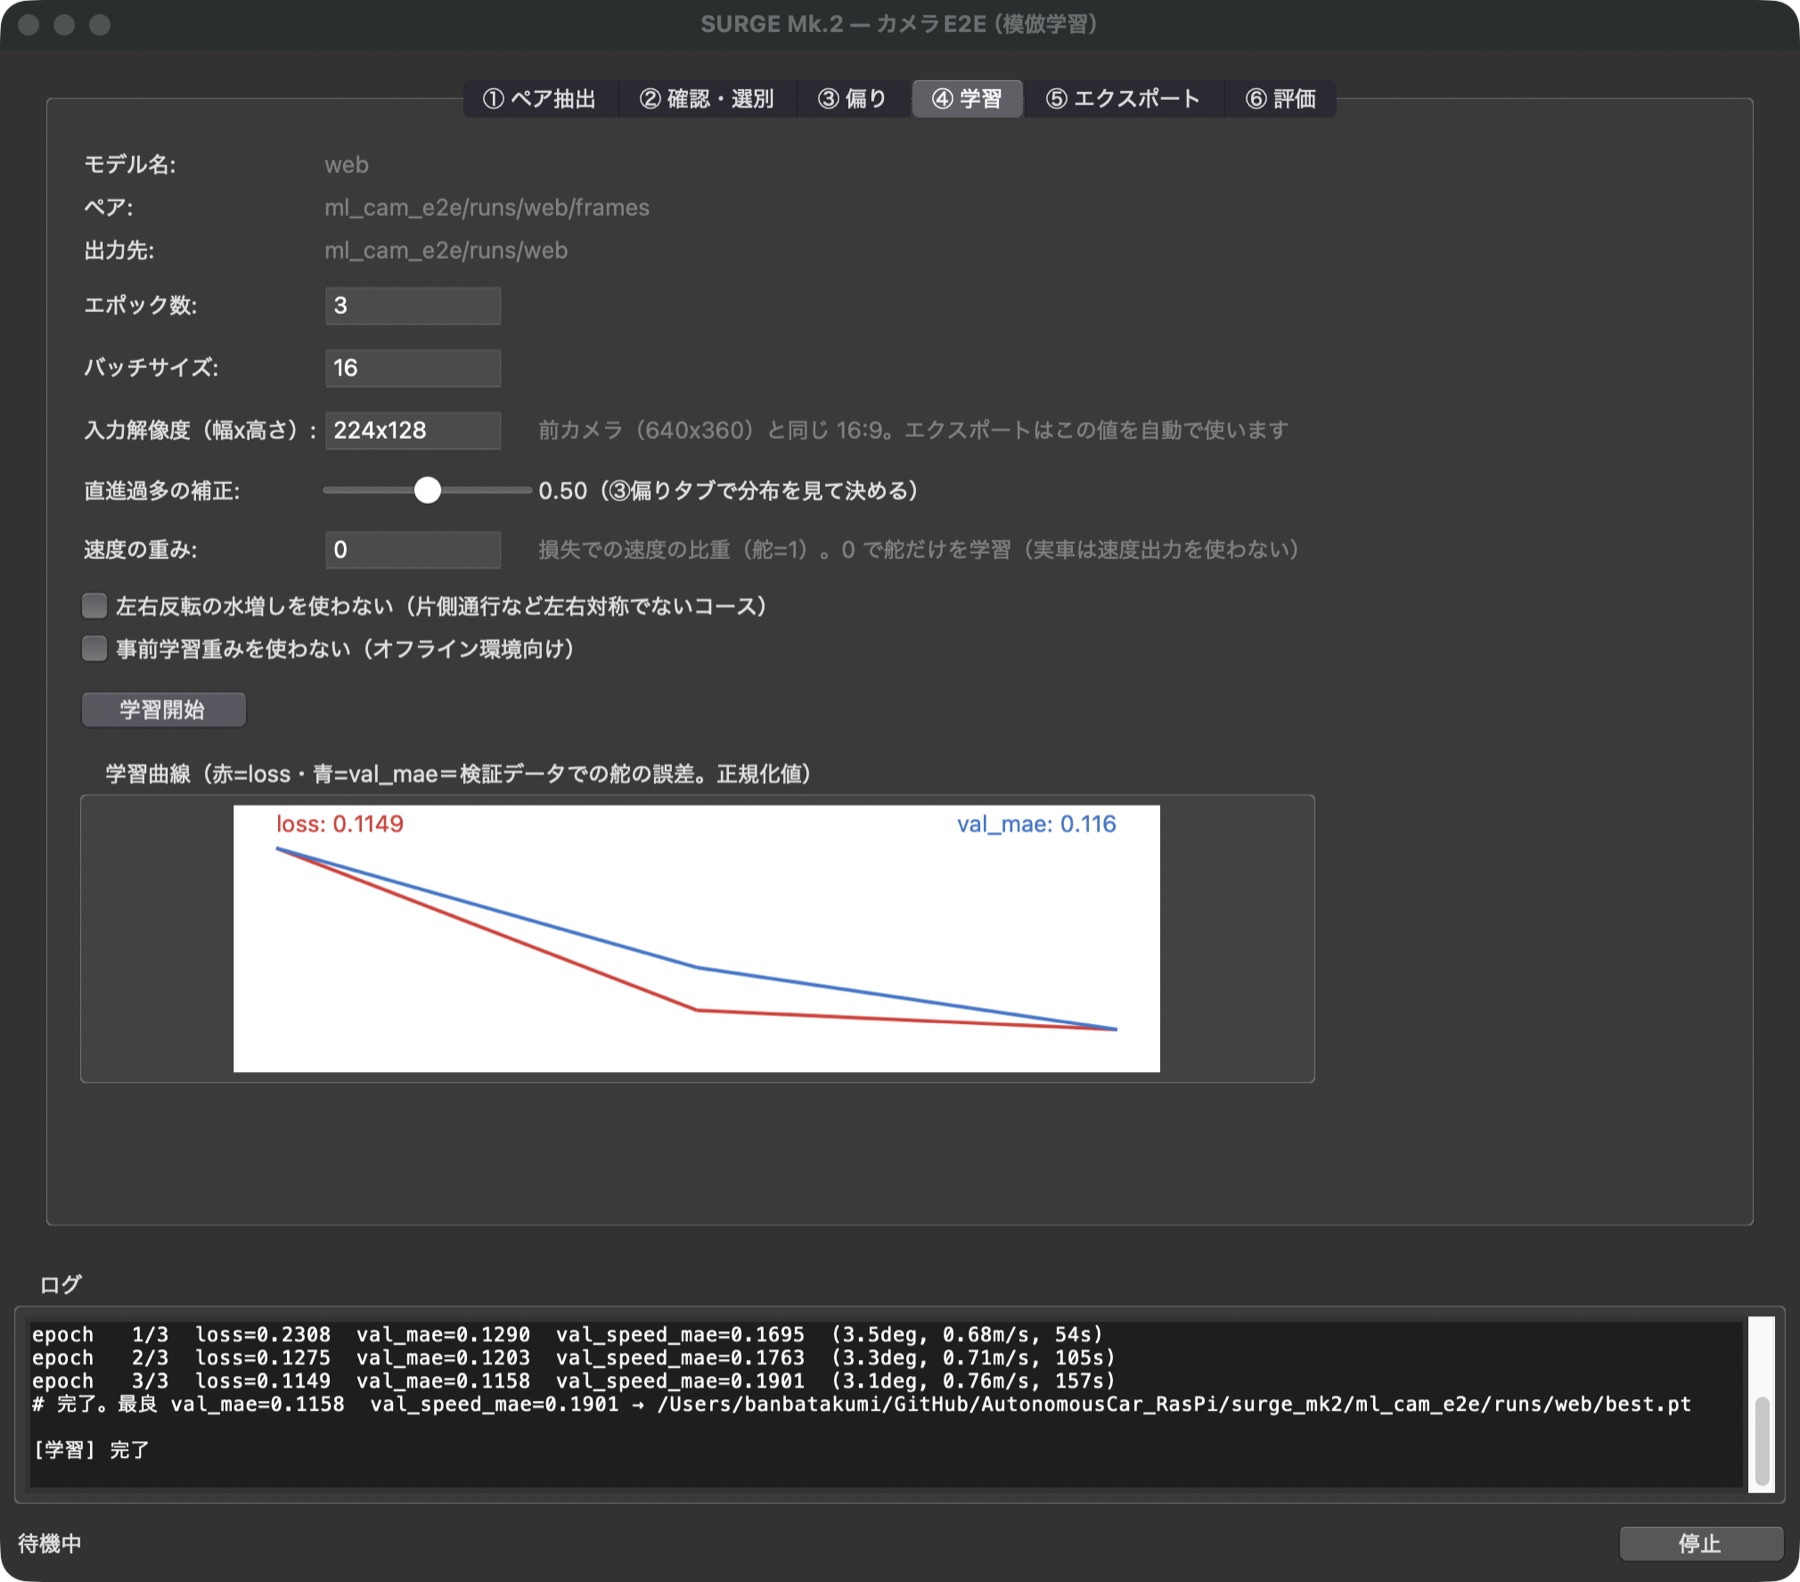
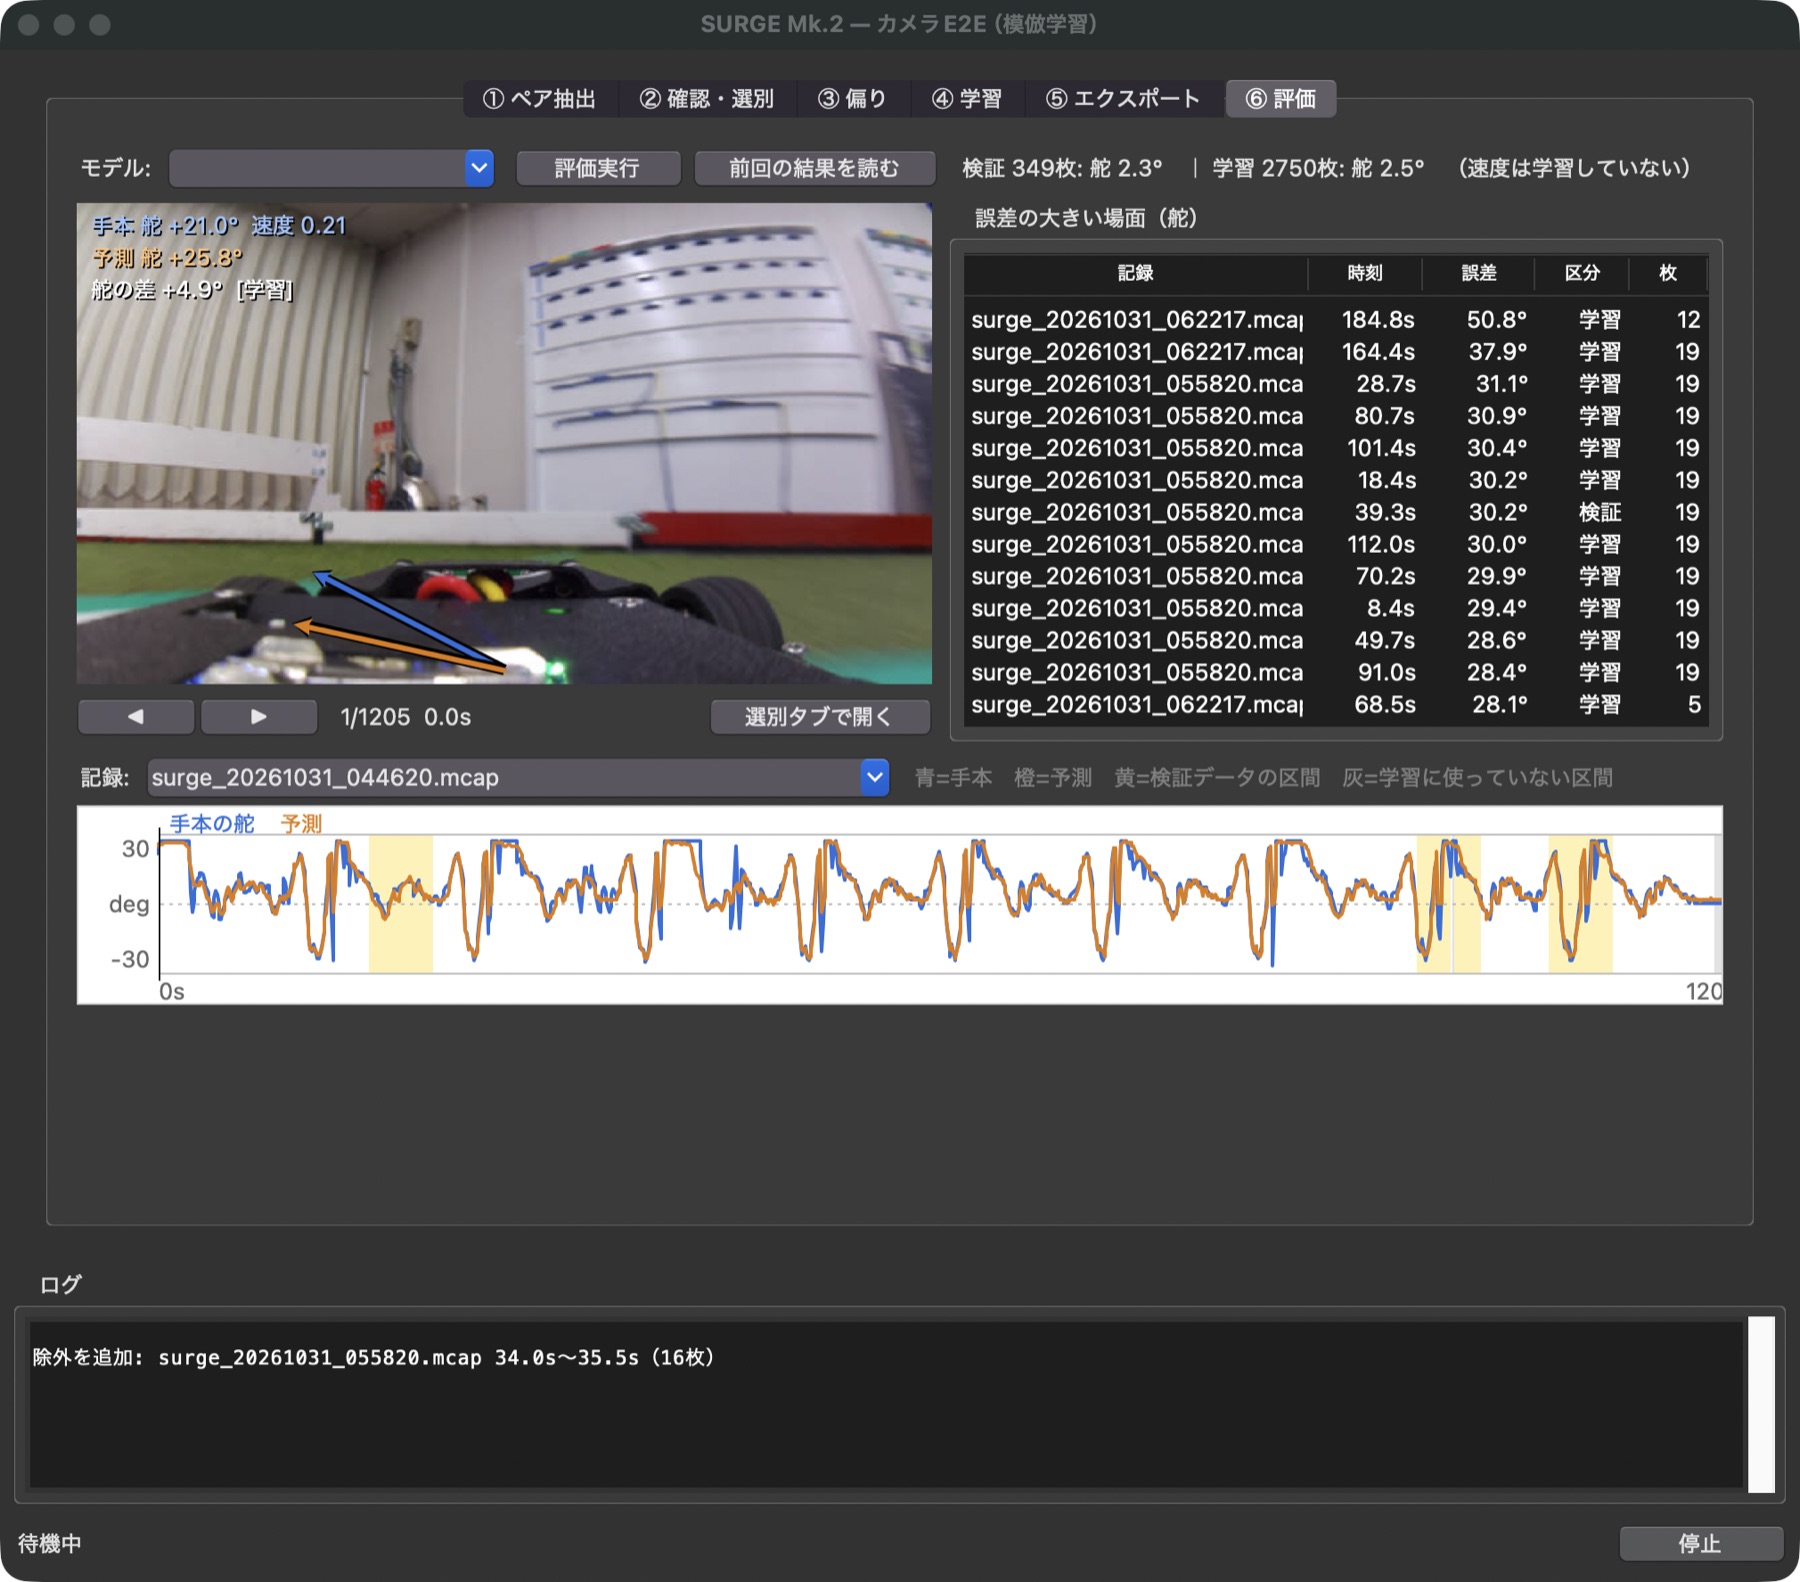
データの取り出しから評価まで、ターミナルを使わずに進められる操作パネル(ml_cam_e2e/app.py)を作りました。タブは作業の順に 6 枚です。
| タブ | すること |
|---|---|
| ① ペア抽出 | 録った mcap から(画像、操作)の組を取り出す。モデル名を決める |
| ② 確認・選別 | 映像と舵・速度の時系列を見ながら、手本にしない区間を範囲で外す |
| ③ 偏り | 舵・速度の分布と、記録ごとの内訳を見る |
| ④ 学習 | 学習を回し、学習曲線を見る |
| ⑤ エクスポート | 実車が読む ONNX と、前処理の約束を書いたファイルを書き出す |
| ⑥ 評価 | 予測と手本の時系列、誤差の大きい場面、ずれへの応答を見る。場面から②へ飛べる |
②と⑥を往復するのが基本です。誤差が大きい場面は、たいてい手本の側が悪い(そこだけ違う操作をしている)からです。
設計の詳細
悪い手本を機械的に外す
教師データは、人や自動運転がその瞬間に実際に出していた指令そのものなので、手でラベルを付ける作業が要りません。
その代わり、質の悪い組を弾く責任が、組を取り出す処理(extract_pairs.py)に集まります。
| 外すもの | 理由 |
|---|---|
| 走行許可(ARM)が無い間 | 待機中は「舵 0」という無意味な信号を混ぜるだけ |
| 自動運転中(既定) | 人を真似たつもりで別の走行モードを真似てしまう。手本にしたいときだけ明示して含める。カメラ E2E 自身の走行は常に外す(自分の誤差を増幅するだけ) |
| トルクモードでの運転 | 目標速度が 0 のままで、速度の手本にならない |
| 画像と指令の時刻が離れすぎた組 | 記録が途切れた区間で、無関係な指令と画像が組になるのを防ぐ |
止まって待つ区間や後退する区間も、学習からは自動で外れます。何枚がどの理由で落ちたかは最後に表示します(全部落ちたのに 0 枚と黙らないため)。
手本は LiDAR の自動運転でもよい
うまく走れている地図走行(slam2d_route)の記録を手本にすると、人より滑らかな運転を、人より多く集められます。
LiDAR で走るモードの運転を、カメラだけで真似させるわけです。
指令を推論の遅れだけ先にずらす
画像と「同じ瞬間の指令」を組にすると、実車ではモデルの舵が推論の遅れの分だけ手本より遅れて出ます(撮影から指令まで約 170 ms、2026-10-30 の実測)。 そこで、画像の 200 ms 後の指令を手本にしています。
| 版 | 指令のずらし | 結果(同じ手本・同じ速度、約 1.1 m/s) |
|---|---|---|
| v6 | 0 ms | 切り始めと戻しが約 0.2 秒遅れ、数 m ごとにぶつかった |
| v7 | 200 ms | 約 2 周(約 28 m)を接触なしで走った |
線から外れたときに戻す舵を教える — 画像をずらす拡張
ここが模倣学習の一番の難所です。 手本はいつも同じ線を走るので、記録には「線から外れた画像と、そこから戻す舵」の組がありません。 そのまま学習したモデルは、ずれを直す舵をほとんど持たず、実車では数 m で線から外れて戻れなくなりました。 模倣学習でよく知られた分布シフトの問題です(Ross ら 2011 の DAgger が扱う問題)。
そこで、NVIDIA の PilotNet(Bojarski ら 2016)と同じ考え方で、記録の画像を「車が向きを ψ だけ変えた画像」に作り替え、ラベルを「そこから戻る舵」に補正します。
作り方には 3 つの工夫があります(yaw_aug.py)。
- 向きの変化を、画像の横ずらしで近似する。 魚眼レンズでは、地平線付近のずれは「焦点距離 × ψ」の画素でほぼ一様です。上下の端ほど近似が崩れるので、±6° の範囲に留めます。
- 端に作り物の画素を出さない。 学習でも推論でも左右を少し切り落とした窓を使い、ずらすのは窓の位置だけにします。 端を引き伸ばして埋めると、その帯がラベルの補正と完全に連動し、モデルが「帯の幅」を手がかりに舵を覚えてしまうからです。
- 車体は動かさない。 カメラは車体に固定なので、車が向きを変えてもボンネットや前輪は同じ所に写ります。 走行中に画素がほとんど変わらない所を記録から推定して車体とみなし、そこだけ元の画像を貼り戻します。
効果(開発記録 2026-10-29〜30)
ずれへの応答 dδ/dψ(車が ψ 向いたときに舵をどれだけ変えるか。負で大きいほど戻す力が強い)で比べました。手本の追従は約 −0.8〜−1.5 です。
| 拡張なし(v4) | 拡張あり(v5) | |
|---|---|---|
| 手本の画像で | −0.20 | −0.81 |
| 学習に使っていない低速走行の画像で | −0.12〜−0.17 | −0.54〜−0.58 |
| 検証データの舵の誤差 | 0.5° | 0.5°(悪化なし) |
v4 はオフラインの評価では完璧(検証誤差 0.5°、相関 0.999)でしたが、実車では数 m で線を外れました。 誤差が小さくても走れるとは限らないので、評価タブでは dδ/dψ も必ず表示するようにしています。
教えられないこと
向きは合っているが壁に寄っている、という横方向の位置のずれは、奥行きの情報が無いと画像から作れません。これは未対策です。
舵の正解を変えない外乱も足す
実車で起きているのに、学習の画像には無かった変化を混ぜ、モデルがそれを舵の手がかりにしないようにします(photo_aug.py)。
| 外乱 | 実車で起きていること |
|---|---|
| 横ブレ | 暗い室内で露出が約 33 ms まで伸び、旋回の速さに比例して画像が横に流れる |
| センサのノイズ | ゲインがほぼ最大なので、暗いほどざらつく |
| 色味 | 窓の外光と室内灯が混ざり、時間で色が変わる |
| JPEG | 学習の画像は記録用の JPEG、実車の推論は圧縮前の画像 |
モデルが画像のブレを舵の手がかりにしていた
手本(速く走った記録)の画像は旋回でブレており、ゆっくり走らせた実車の画像はくっきりしていました。 手本より遅く走らせると舵が足りなくなり、画像に横ブレを足すと舵が戻りました。ブレを外乱として学習に混ぜた v8 では、横ブレによる舵の変化が 3.5〜3.7° から 0.6〜1.0° に減りました。 それでも、手本は実車で走らせる速度で録るのが原則です。
直進ばかりのデータへの対処
舵 0 付近が大半を占めるデータをそのまま学習すると、「常に直進」と答えるのが誤差を最小にしてしまいます。 枚数を捨てて間引くのではなく、舵の区間ごとに抽選の重みを変えて、カーブを多めに見せます。左右反転の水増しも既定で使います(コースが左右非対称なら切れます)。
学習と推論で前処理を同じにする
画像の切り出し・縮小・正規化は、学習と推論で同じ関数を使います。処理を変えたら版の番号を上げ、版の違うモデルは実車のノードが読み込みを拒否します。 「学習のときと違う絵を見せて走らせていた」という、気づきにくい失敗を防ぐためです。
このモードは自分では止まらない
LiDAR を見ないので、前に物があってもモデルが「進め」と出せば進みます。学習データに無い場面での振る舞いは、原理的に保証できません。 走らせるときは GUI で STM32 の自動停止(LiDAR による停止距離)を有効にし、人が舵・スロットル・ブレーキに触れた瞬間に解除される仕組みと合わせて使います。
これから
LiDAR だけ、カメラだけの E2E から、両方を組み合わせた E2E へ進みました(E2E 融合。実走はこれから)。
隣のしくみへ